

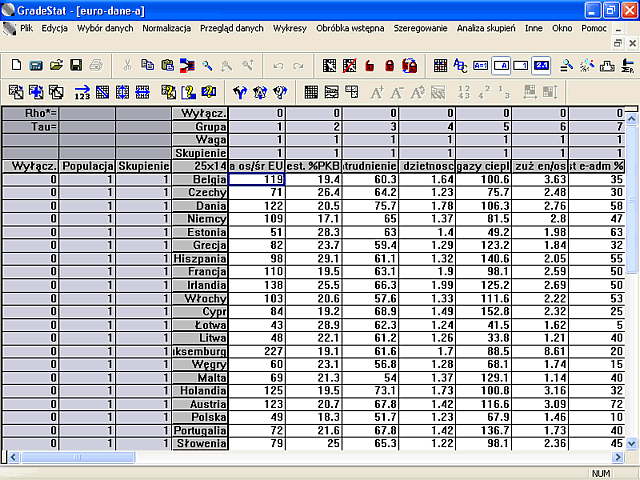
Kliknij strzałkę w dół przy pionowym pasku przewijania, by zobaczyć pomocnicze wiersze u dołu tabeli.
Na białym tle widać obszar danych, które podlegają analizie. Uruchomienie np. procedury GCA powoduje jej wykonanie dla wszystkich obserwacji w białych polach. Lewa szara kolumna to nazwy wierszy (obserwacji), przed nią znajdują sie trzy kolumny fioletowe:
Wyłącz - pokazuje, ile pól w danym wierszu jest wyłączonych z analizy (w tej chwili 0),
Populacja - obserwacje należące do tej samej populacji mają w tej kolumnie tę samą liczbę. Faktyczna wartość liczby nie ma znaczenia, ważne jest tylko, że różne liczby służą jako identyfikatory odmiennych populacji. Podział na populacje z reguły zostaje przeprowadzony przez użytkownika i jest użyteczny np. przy agregacji.
Skupienie - odmienne liczby to odmienne skupienia. Domyślnie wszystkie obserwacje mają te same liczby w kolumnie Skupienie, a po przeprowadzeniu GCCA (procedury GCA połączonej z analizą skupień) obserwacje należące do różnych skupień mają w tej kolumnie przypisane inne liczby.Powyżej białego obszaru znajduje się szary wiersz z nazwami kolumn (zmiennych) oraz analogiczne jak dla obserwacji wiersze Skupienie i Wyłączone. Oprócz tego jest też wiersz Waga, pozwalający nadać zmiennym różne wagi (domyślnie wszystkie mają takie same) oraz wiersz Grupa. Zmienne znajdujące się w tej samej grupie są wspólnie normalizowane. Normalizacja polega na podzieleniu przez średnią w danej grupie. W przypadku danych wielowymiarowych najczęściej zmienne trzeba rozdzielić do osobnych grup, np. gdy są mierzone w innych jednostkach lub po prostu nie są ze sobą porównywalne. Trudno jednak podać żelazną regułę, czasem trzeba wypróbować kilka wariantów podziału zmiennych na grupy.
Copyright (c) Maria Grzegorek i Emilia Jarochowska